

Goldshell KD BOX PRO 2600Gh/s 230w
Platforma klasy korporacyjnej, składana i testowana w UE.
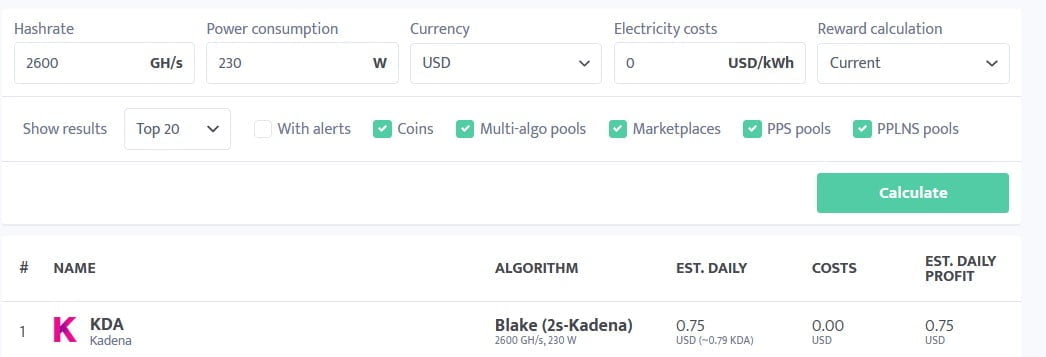
Goldshell KD BOX PRO wykorzystuje algorytm Blake2S do kopania Kadena, maksymalny hashrate wynosi 2.6Th/s, a pobór mocy 230W.
Opis produktu
| Parametry | |
|---|---|
| Domyślny tryb hashrate: 2.6TH/S±5% | Pobór mocy w trybie domyślnym: 230W±5% |
| Tryb niskiego poboru mocy: brak | Tryb niskiego poboru mocy: brak |
| Temperatura pracy: 0~35℃ | Wymiary: 178mm*150mm*84mm |
| Hałas: ≤35db | Port połączeniowy: Ethernet |
| BEZ ZASILACZA | Waga netto: 2kg |
Kalkulator opłacalności kopania Kadena
Uwaga!
Produkt nie zawiera zasilacza.
Wymagania dotyczące zasilacza ATX dla BOX PRO są następujące:
Zasilacz ATX musi mieć moc co najmniej 500W.
Należy przygotować dwa kable zasilające 16AWG.
Zasilacz musi obsługiwać dwa porty zasilania 12V do podłączenia.
Oba złącza 6-pin należy podłączyć do KD BOX PRO jednocześnie; podłączenie tylko jednego złącza jest surowo zabronione. W przeciwnym razie może to skrócić żywotność koparki.
Pytania, które kupujący zadają nam najczęściej przed zamówieniem serwera.
Ile to trwa?
Maszyny budowane z podzespołów, które mamy na stanie, wysyłamy szybko; wszystko, co wymaga konkretnej generacji GPU, zależy od dostępności. Termin podajemy przed płatnością, a jeśli się przesunie, informujemy o tym sami, zamiast pozostawiać Państwa w niepewności.
Czy konfigurację można zmienić przed montażem?
Niemal zawsze. Karty GPU, pamięć, nośniki i chłodzenie dobieramy pod konkretne zamówienie, a podana konfiguracja jest punktem wyjścia, a nie sztywnym pakietem. Jeśli potrzebują Państwo więcej VRAM, szybszych nośników lub innego rozwiązania chłodzenia, prosimy o informację przed złożeniem zamówienia — wycenimy zmianę.
Czy serwer można odebrać osobiście?
Jak najbardziej. Nasz magazyn znajduje się w Pradze i zapraszamy po odbiór osobisty — większość osób, które przyjeżdżają, wykorzystuje wizytę na przejrzenie maszyny razem z naszym inżynierem i zadanie pytań, które źle się zadaje mailem. Przy zamówieniach na terenie Czech staramy się również dostarczyć sprzęt osobiście i na miejscu przeprowadzić Państwa przez konfigurację.
Czy można porozmawiać z kimś, kto naprawdę rozumie to obciążenie?
Tak. Mamy inżyniera, który zajmuje się wyłącznie systemami AI, a nie ogólny dział sprzedaży. Jeśli pytanie dotyczy rozmiarów batcha, kwantyzacji, interconnectu albo tego, gdzie pojawi się wąskie gardło — prosimy je zadać. Taka rozmowa zwykle zmienia konfigurację na lepsze.
Jaki model można uruchomić w tej konfiguracji?
Tak. Każda maszyna jest składana, poddawana testom burn-in i benchmarkom na rzeczywistych obciążeniach AI przed wysyłką, a opuszcza nas z zainstalowanym i działającym modelem LLM. Wystarczy ją podłączyć do zasilania i sieci, aby rozpocząć pracę — jedyną decyzją, jaka pozostaje, jest to, który projekt uruchomić jako pierwszy.
Jak testujemy serwer przed wysyłką?
Testujemy go na rzeczywistych obciążeniach AI, a nie na syntetycznych wynikach punktowych: przepustowość inferencji, zachowanie przy trwałym obciążeniu i temperatury w pracy ciągłej. Wyniki benchmarków otrzymują Państwo razem z maszyną, więc obiecana wydajność to dokładnie ta wydajność, którą można zweryfikować pierwszego dnia.
Czy serwer po dostarczeniu jest gotowy do pracy?
Tak. Każda maszyna jest składana, poddawana testom burn-in i benchmarkom na rzeczywistych obciążeniach AI przed wysyłką, a opuszcza nas z zainstalowanym i działającym modelem LLM. Wystarczy ją podłączyć do zasilania i sieci, aby rozpocząć pracę — jedyną decyzją, jaka pozostaje, jest to, który projekt uruchomić jako pierwszy.
Wysyłka z naszego magazynu w UE. Ciężkie przedmioty mogą wymagać zorganizowania transportu spedycyjnego — prosimy o kontakt w sprawie wyceny wysyłki i terminu realizacji. 2-letnia gwarancja ograniczona z zaawansowanym wsparciem RMA; dostępne przedłużenie gwarancji.
Nie znaleźli Państwo tego, czego szukają?
Prosimy opisać swoje obciążenie, a dobierzemy tę platformę pod nie — GPU, pamięć, dyski i chłodzenie dopasowane do tego, co faktycznie Państwo uruchamiają.