

NVIDIA CMP HX90 – GPU de mineração – 97MH/s
Plataforma de nível empresarial, montada e testada na UE.
Nvidia CMP 90 HX90 – Trata-se de uma placa gráfica profissional da NVIDIA
Parâmetros: Esta é uma placa gráfica profissional ✔ Hash rate em Ethereum(1) : 97-100 MH/s ✔ Conectores de alimentação(2) : 2x 8 pinos ✔ Tamanho da memória : 10GB ✔ Consumo : 210-250w A NVIDIA CMP HX90, construída num processo de 8nm e assente numa GPU GA102, suporta DirectX 12 Ultimate. É um chip GPU GA102 de grandes dimensões, com uma área de matriz de 628 mm e 28,300 milhões de transístores.
NVIDIA CMP HX90 concebida para profissionais
Otimizada para mineração de criptomoedas
A arquitetura GPU da NVIDIA permite rentabilizar de forma mais eficiente e recuperar mais depressa o investimento em mineração. A plataforma 90HX é uma solução comprovada para qualquer sistema de mineração.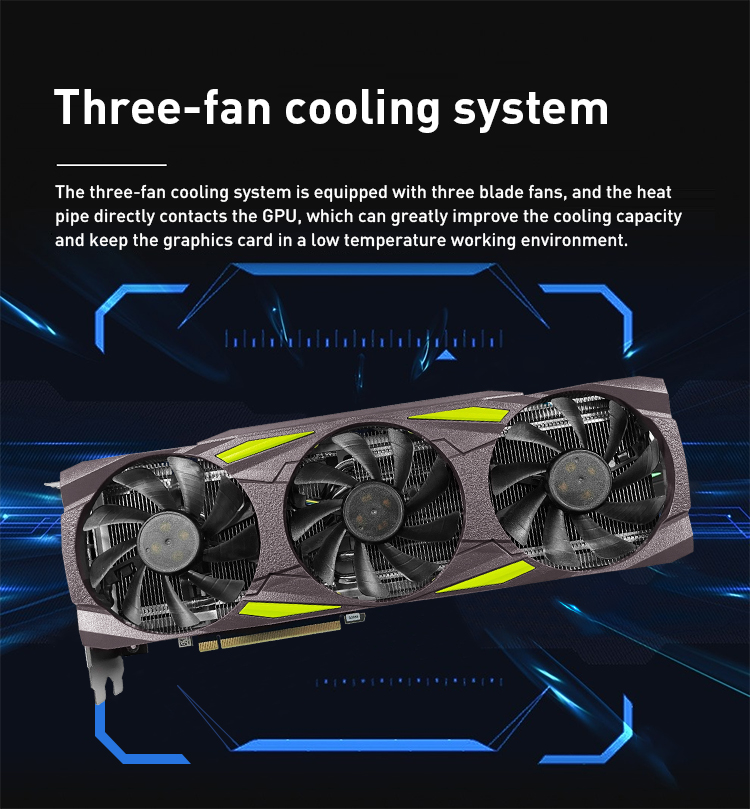
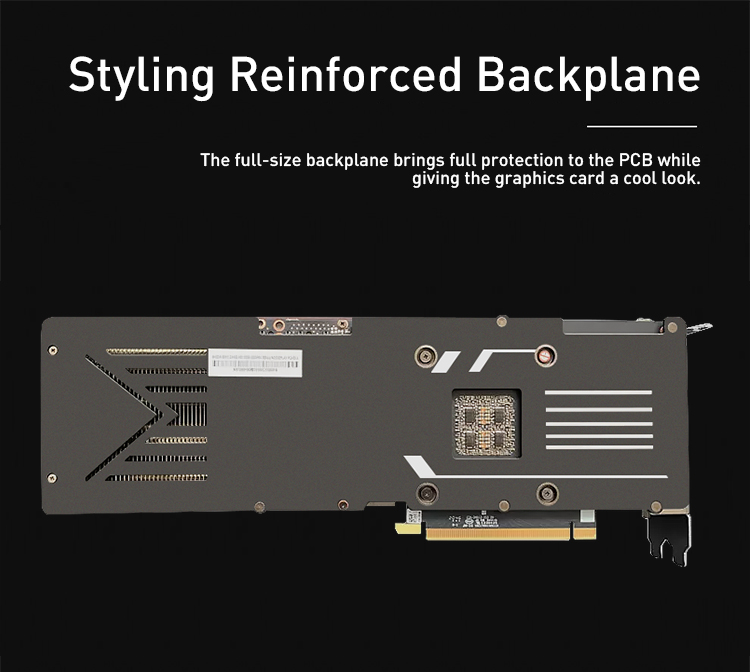
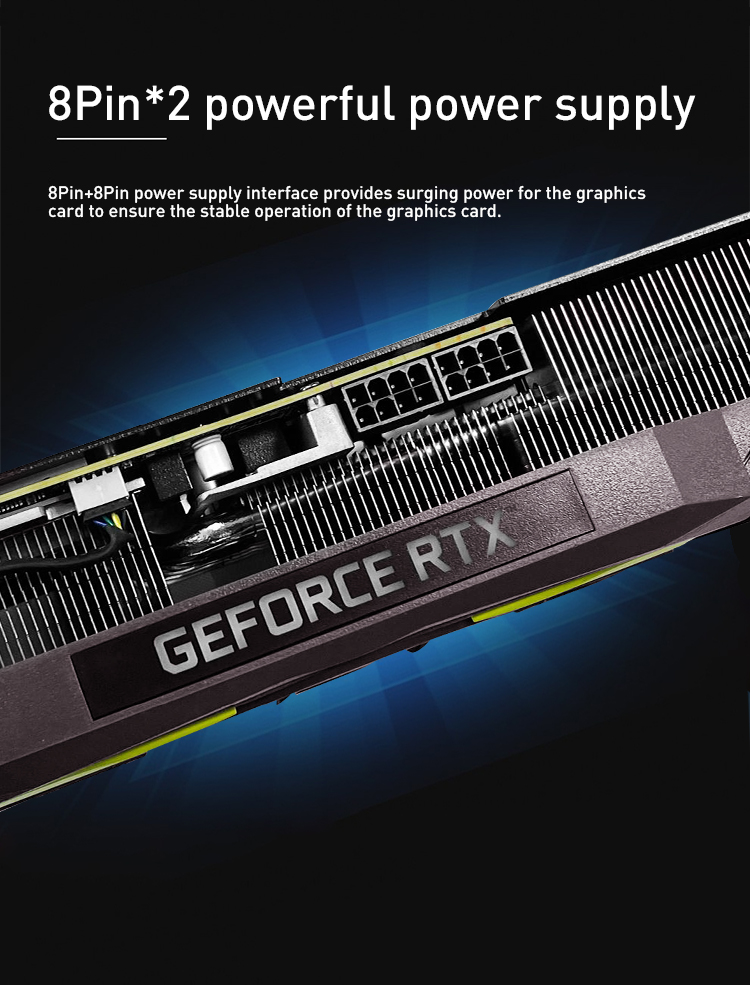
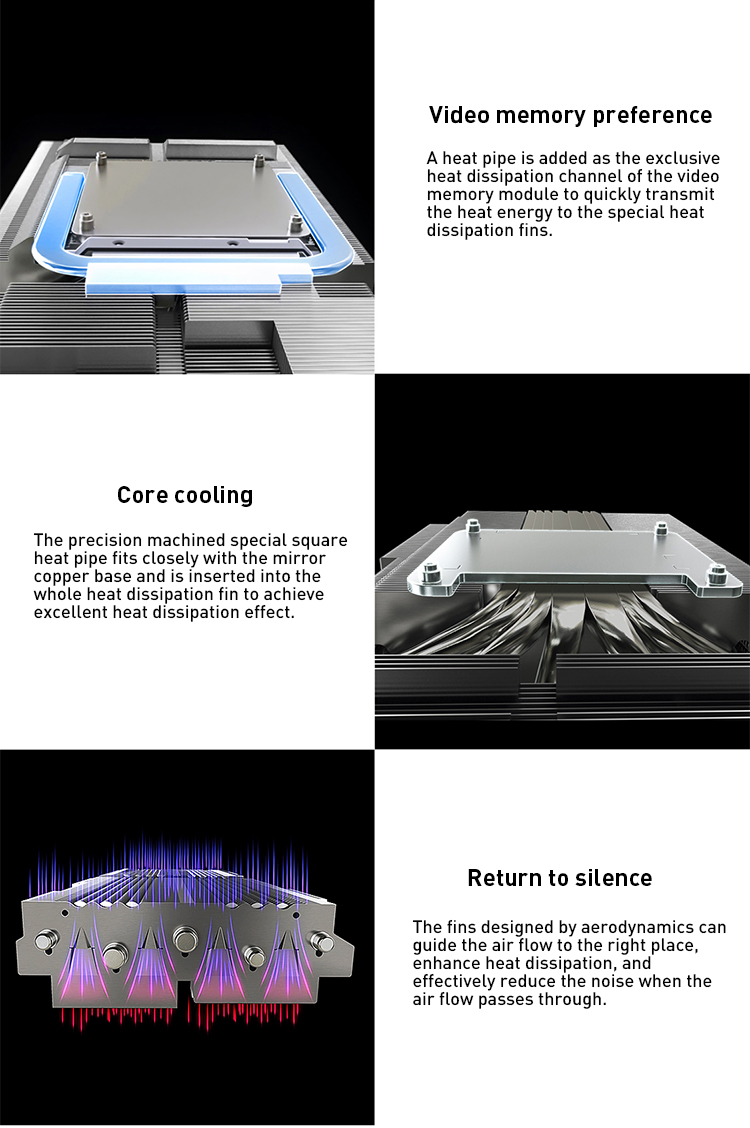

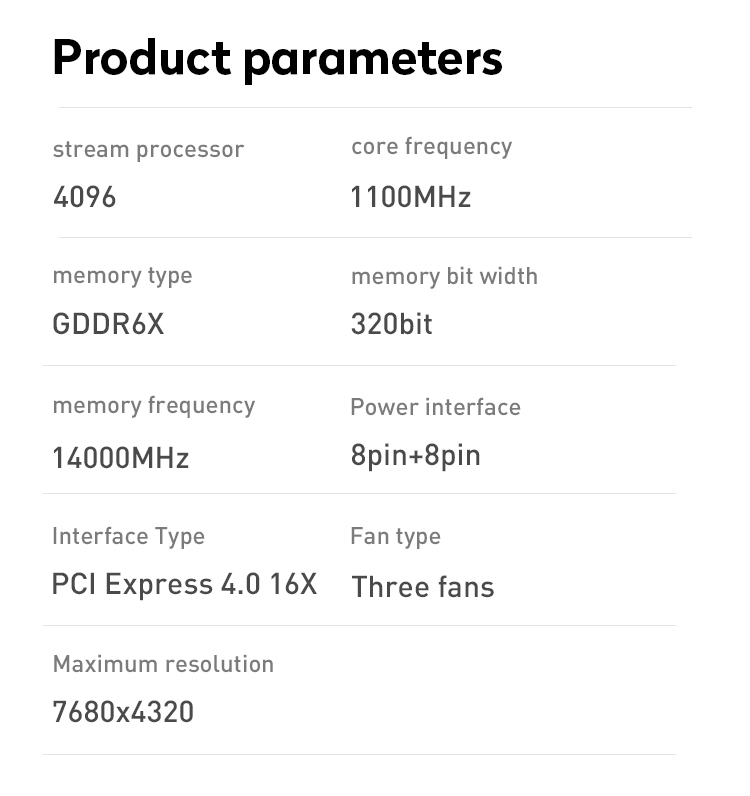
 A placa dispõe também de 50 núcleos de aceleração para ray tracing. A NVIDIA associou 10 GB de memória GDDR6X à CMP 90HX, que utiliza uma interface de memória de 320 bits. A GPU funciona a 1500 MHz, podendo chegar aos 1710 MHz em boost, e a memória a 1188 MHz (19 Gb / s efetivos). Sendo uma placa de dois slots, a NVIDIA CMP 90HX é alimentada por dois conectores de alimentação de 8 pinos, com um consumo máximo de 320W.
 Este equipamento não tem saídas de vídeo, porque não foi concebido para ligar monitores. A CMP 90HX liga-se ao resto do sistema através da interface PCI-Express 4.0 x16. A placa tem 285 mm de comprimento, 112 mm de largura e está equipada com uma solução de arrefecimento de dois slots. com um consumo máximo de 320 watts. Este equipamento não tem saídas de vídeo, porque não foi concebido para ligar monitores. A CMP 90HX liga-se ao resto do sistema através da interface PCI-Express 4.0 x16. A placa tem 285 mm de comprimento, 112 mm de largura e está equipada com uma solução de arrefecimento de dois slots. com um consumo máximo de 320 watts.
As perguntas que os compradores mais nos fazem antes de encomendar um servidor.
Quanto tempo demora?
As máquinas construídas a partir de componentes que temos em stock são expedidas rapidamente; tudo o que exija uma geração específica de GPU depende da disponibilidade. Indicamos uma data antes do pagamento e, se essa data mudar, informamos o cliente em vez de o deixar descobrir por si.
A configuração pode ser alterada antes da montagem?
Quase sempre. As GPU, a memória, o armazenamento e o arrefecimento são escolhidos em cada encomenda e a configuração indicada é um ponto de partida, não um pacote fixo. Se precisar de mais VRAM, de armazenamento mais rápido ou de outra abordagem de arrefecimento, diga-nos antes de encomendar e orçamentamos a alteração.
Posso levantar o servidor pessoalmente?
Pode, sim. O nosso armazém fica em Praga e o levantamento em pessoa é bem-vindo — a maioria de quem nos visita aproveita para rever a máquina com o nosso engenheiro e fazer as perguntas que são difíceis de resolver por e-mail. Nas encomendas dentro da República Checa tentamos também entregar pessoalmente e explicar a instalação no local.
Posso falar com alguém que perceba mesmo da carga de trabalho?
Sim. Temos um engenheiro dedicado especificamente a sistemas de IA, e não um balcão de vendas genérico. Se a sua pergunta é sobre tamanhos de lote, quantização, interligação ou onde estará o seu estrangulamento, coloque-a — essa conversa costuma melhorar a configuração final.
Que modelo posso executar nesta configuração?
Sim. Todas as máquinas são montadas, submetidas a testes de burn-in e avaliadas com cargas de trabalho de IA reais antes do envio, e saem das nossas instalações com um LLM já instalado e a funcionar. Basta ligá-la à corrente, ligá-la à sua rede e começar a trabalhar — a única decisão que resta é qual o primeiro projeto que irá correr.
Como testam um servidor antes da expedição?
Testamo-lo com cargas de trabalho de IA reais, e não com pontuações sintéticas: débito de inferência, comportamento sob carga sustentada e desempenho térmico em funcionamento contínuo. Os resultados dos benchmarks seguem com a máquina, por isso o desempenho prometido é o desempenho que pode verificar logo no primeiro dia.
O servidor chega pronto a funcionar?
Sim. Todas as máquinas são montadas, submetidas a testes de burn-in e avaliadas com cargas de trabalho de IA reais antes do envio, e saem das nossas instalações com um LLM já instalado e a funcionar. Basta ligá-la à corrente, ligá-la à sua rede e começar a trabalhar — a única decisão que resta é qual o primeiro projeto que irá correr.
Expedido a partir do nosso armazém na UE. Os artigos pesados podem exigir transporte de carga — contacte-nos para obter um orçamento de envio e o prazo de entrega. Garantia limitada de 2 anos com apoio RMA avançado; garantia alargada disponível.
Não é exatamente o que procura?
Diga-nos qual é a sua carga de trabalho e configuramos esta plataforma à sua medida — GPU, memória, armazenamento e arrefecimento ajustados ao que realmente executa.