

NVIDIA CMP HX90 – GPU de minage – 97MH/s
Plateforme de qualité professionnelle, assemblée et testée dans l'UE.
Nvidia CMP 90 HX90 – il s'agit d'une carte graphique professionnelle signée NVIDIA
Caractéristiques : Il s'agit d'une carte graphique professionnelle ✔ Taux de hash Ethereum(1) : 97-100 MH/s ✔ Connecteurs d'alimentation(2) : 2x 8 broches ✔ Mémoire : 10GB ✔ Consommation : 210-250w La NVIDIA CMP HX90, gravée en 8nm et animée par un GPU GA102, prend en charge DirectX 12 Ultimate. Il s'agit d'une grande puce GPU GA102, d'une surface de 628 mm et comptant 28,300 millions de transistors.
NVIDIA CMP HX90, conçue pour les professionnels
Optimisée pour le minage de cryptomonnaies
L'architecture GPU de NVIDIA vous permet de gagner en efficacité et de rentabiliser plus vite votre investissement dans le minage. La plateforme 90HX est une solution éprouvée pour tout système de minage.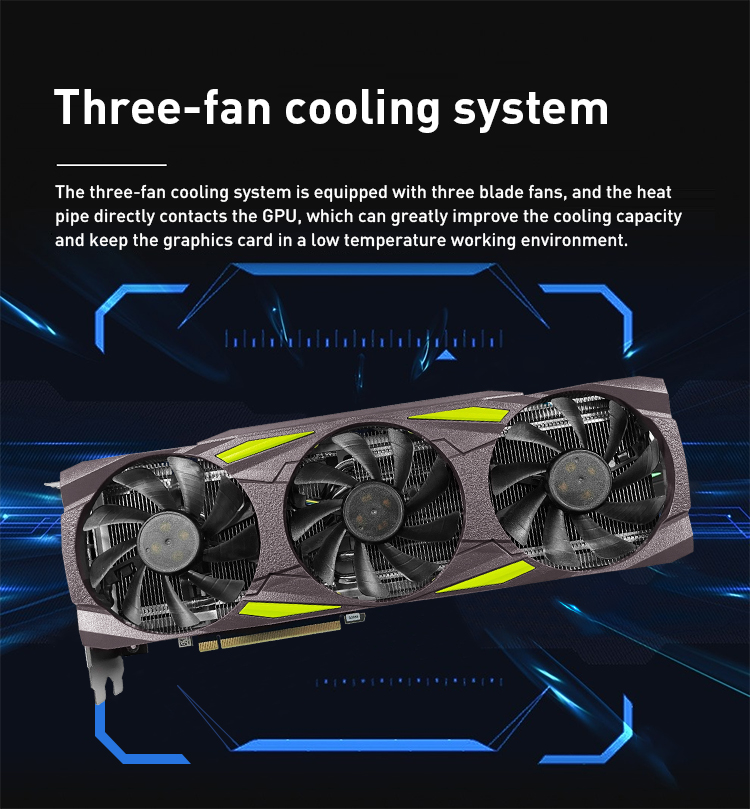
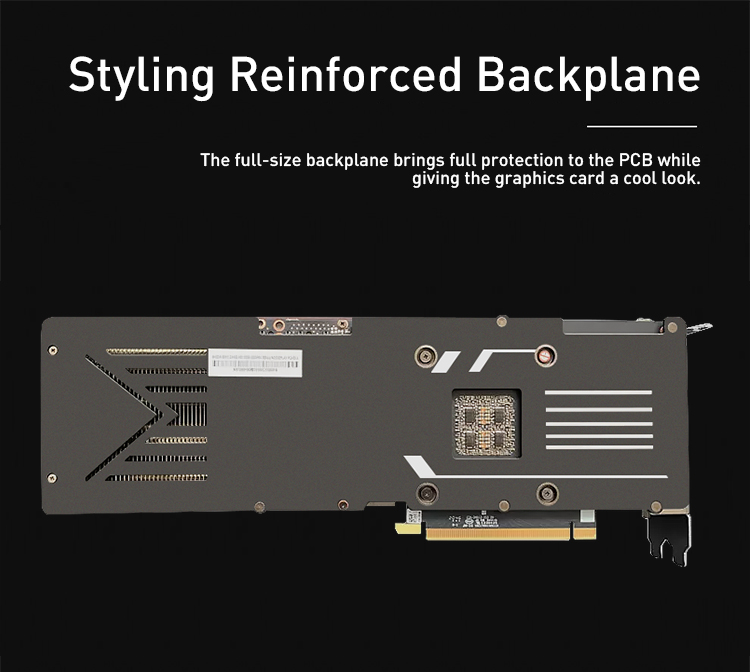
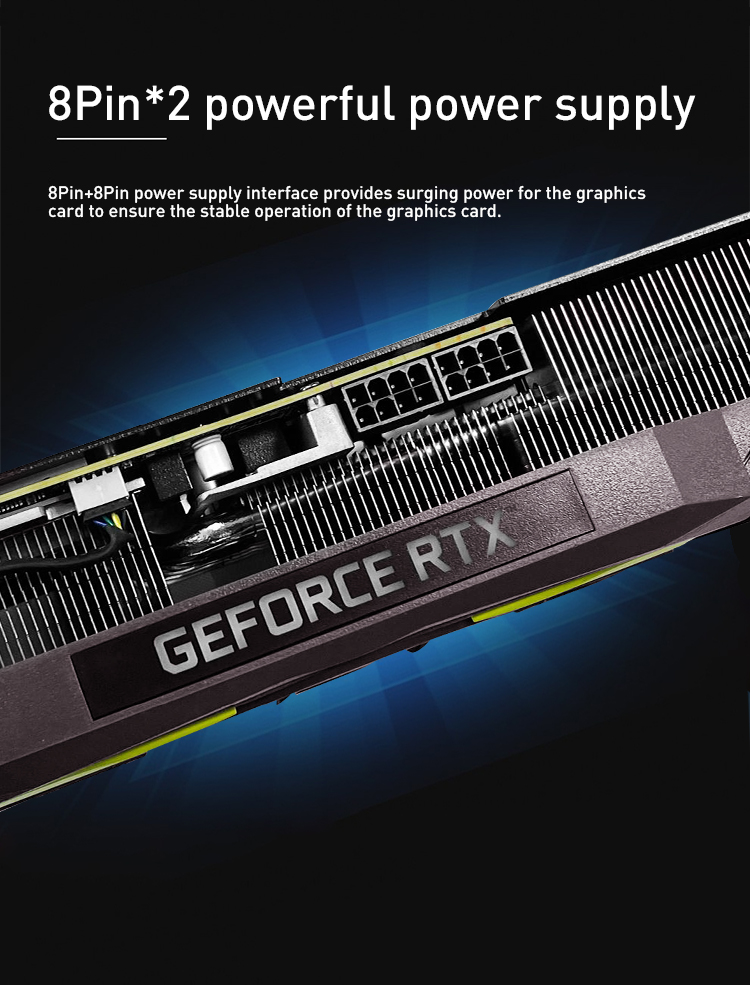
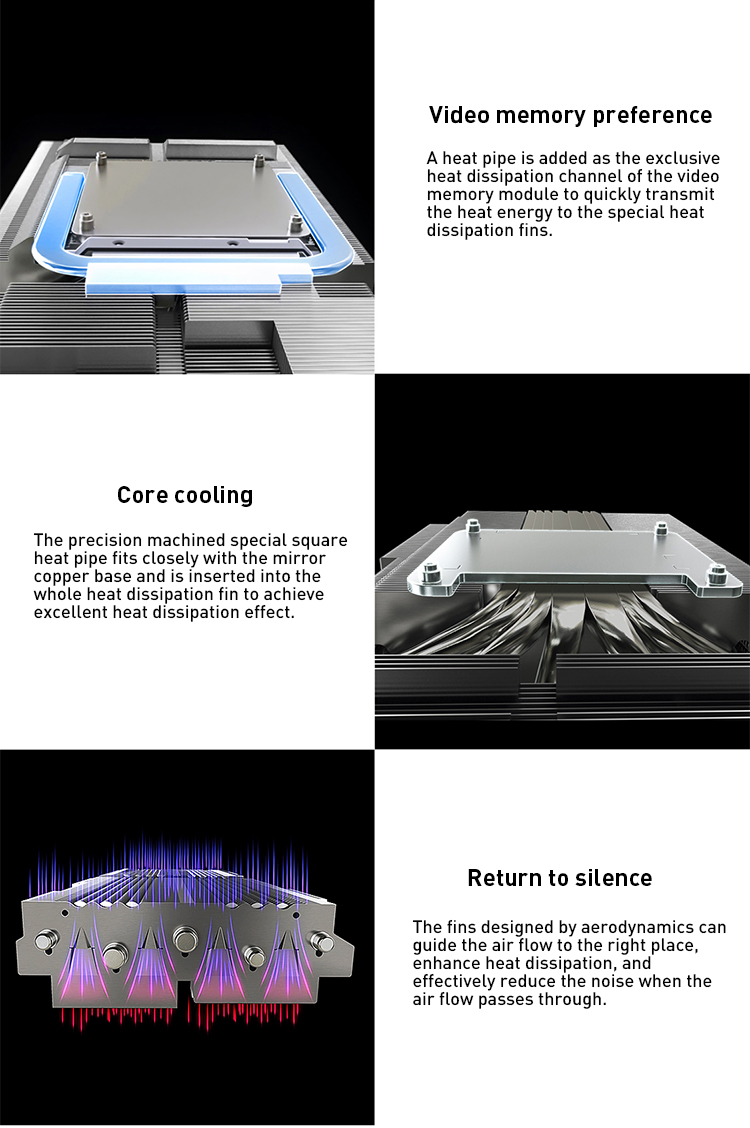

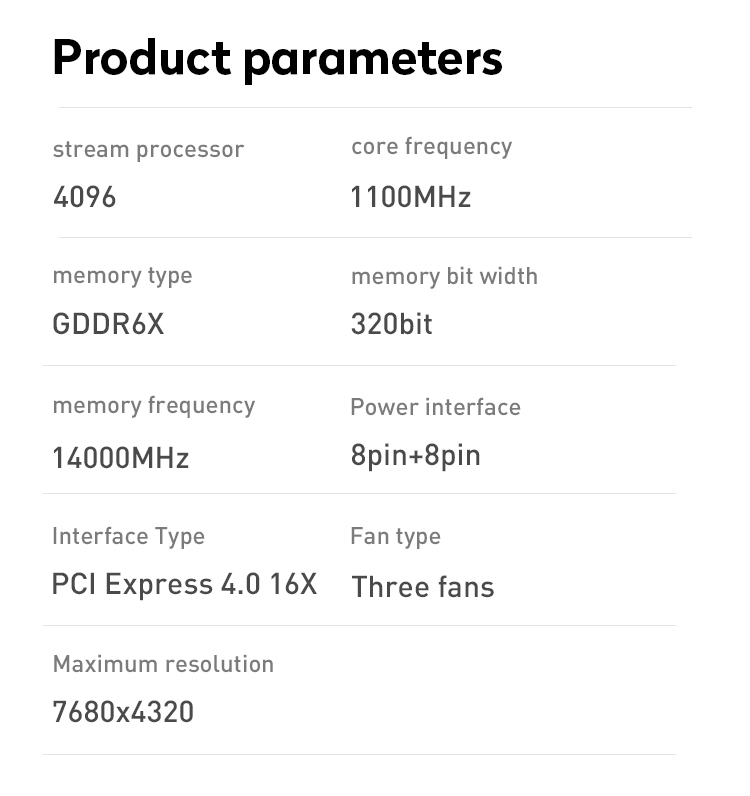
 La carte embarque également 50 cœurs d'accélération dédiés au ray tracing. NVIDIA a associé 10 GB de mémoire GDDR6X à la CMP 90HX, via une interface mémoire 320 bits. Le GPU fonctionne à 1500 MHz et peut monter jusqu'à 1710 MHz ; la mémoire tourne à 1188 MHz (soit 19 Gb/s effectifs). Carte à deux slots, la NVIDIA CMP 90HX est alimentée par deux connecteurs 8 broches, pour une consommation maximale de 320W.
 Cet appareil ne dispose d'aucune connectique d'affichage, car il n'est pas conçu pour brancher des moniteurs. La CMP 90HX se connecte au reste du système via l'interface PCI-Express 4.0 x16. La carte mesure 285 mm de long et 112 mm de large, et est dotée d'une solution de refroidissement à deux slots, pour une consommation maximale de 320 watts. Cet appareil ne dispose d'aucune connectique d'affichage, car il n'est pas conçu pour brancher des moniteurs. La CMP 90HX se connecte au reste du système via l'interface PCI-Express 4.0 x16. La carte mesure 285 mm de long et 112 mm de large, et est dotée d'une solution de refroidissement à deux slots, pour une consommation maximale de 320 watts.
Les questions que les acheteurs nous posent le plus fréquemment avant de commander un serveur.
Combien de temps cela prend-il ?
Les machines assemblées à partir de composants que nous avons en stock partent vite ; tout ce qui exige une génération de GPU précise dépend de l'approvisionnement. Nous vous donnons une date avant le paiement et, si elle bouge, nous vous prévenons plutôt que de vous laisser le découvrir.
La configuration peut-elle être modifiée avant l'assemblage ?
Presque toujours. Les GPU, la mémoire, le stockage et le refroidissement sont choisis commande par commande, et la configuration affichée est un point de départ plutôt qu'un ensemble figé. Si vous avez besoin de plus de VRAM, d'un stockage plus rapide ou d'une autre approche de refroidissement, dites-le nous avant de commander et nous chiffrerons la modification.
Puis-je venir récupérer le serveur sur place ?
Bien sûr. Notre entrepôt est à Prague et le retrait sur place est le bienvenu — la plupart de ceux qui viennent en profitent pour passer la machine en revue avec notre ingénieur et poser les questions qui passent mal par e-mail. Pour les commandes en République tchèque, nous essayons aussi de livrer en personne et de vous accompagner dans l'installation sur site.
Puis-je parler à quelqu'un qui comprend vraiment la charge de travail ?
Oui. Nous avons un ingénieur dédié aux systèmes d'IA, et non un simple service commercial. Si votre question porte sur les tailles de batch, la quantification, l'interconnexion ou l'endroit où se situera votre goulot d'étranglement, posez-la — cette conversation améliore généralement la configuration.
Quel modèle puis-je faire tourner sur cette configuration ?
Oui. Chaque machine est assemblée, soumise à un test de rodage et évaluée sur de véritables charges de travail IA avant son expédition, et elle quitte nos ateliers avec un LLM déjà installé et opérationnel. Vous la branchez, vous la connectez à votre réseau et vous commencez à travailler — la seule décision qui vous reste est de choisir le premier projet qu'elle fera tourner.
Comment testez-vous un serveur avant son expédition ?
Nous les éprouvons sur de véritables charges de travail IA plutôt que sur des scores synthétiques : débit d'inférence, tenue en charge soutenue et comportement thermique en fonctionnement continu. Vous recevez les résultats des tests avec la machine : les performances promises sont donc celles que vous pouvez vérifier dès le premier jour.
Le serveur est-il prêt à fonctionner à son arrivée ?
Oui. Chaque machine est assemblée, soumise à un test de rodage et évaluée sur de véritables charges de travail IA avant son expédition, et elle quitte nos ateliers avec un LLM déjà installé et opérationnel. Vous la branchez, vous la connectez à votre réseau et vous commencez à travailler — la seule décision qui vous reste est de choisir le premier projet qu'elle fera tourner.
Expédition depuis notre entrepôt dans l’UE. Les articles lourds peuvent nécessiter un transport en fret — contactez-nous pour un devis d’expédition et un délai de livraison. Garantie limitée de 2 ans avec support RMA avancé ; extension de garantie disponible.
Pas tout à fait ce qu'il vous faut ?
Dites-nous votre charge de travail et nous configurons cette plateforme autour d'elle — GPU, mémoire, stockage et refroidissement adaptés à ce que vous exécutez vraiment.